Entropy
Definition
The entropy of a random variable X X X
H [ X ] = E [ log 2 1 Pr [ X ] ]
\mathbf{H}[X] = \mathbb{E} \left[ \log_2 \frac{1}{\Pr[X] } \right]
H [ X ] = E [ log 2 Pr [ X ] 1 ] Here we adopt the convention that 0 log 0 = 0 0 \log 0 = 0 0 log 0 = 0 lim x → 0 + x log x = lim x → ∞ 1 x log 1 x = 0 \lim_{x \rightarrow 0^+} x \log x = \lim_{x \rightarrow \infty} \frac{1 }{ x } \log \frac{1 }{ x } = 0 lim x → 0 + x log x = lim x → ∞ x 1 log x 1 = 0
Properties
The entropy is oblivious to the specific values X X X X X X
Example.
X 1 = { e 1000 , with probability 0.5 0 , with probability 0.5 X_1 = \begin{cases}
e^{1000}, \text{with probability 0.5} \\ 0, \text{with probability 0.5}
\end{cases} X 1 = { e 1000 , with probability 0.5 0 , with probability 0.5 X 2 = { 1 , with probability 0.5 − 1 , with probability 0.5 X_2 = \begin{cases}
1, \text{with probability 0.5} \\ -1, \text{with probability 0.5}
\end{cases} X 2 = { 1 , with probability 0.5 − 1 , with probability 0.5
Both
H [ X 1 ] = H [ X 2 ] = 0.5 log 2 2 + 0.5 log 2 2 = 1 \mathbf{H}[X_1] = \mathbf{H}[X_2] = 0.5 \log_2 2 + 0.5 \log_2 2 = 1 H [ X 1 ] = H [ X 2 ] = 0.5 log 2 2 + 0.5 log 2 2 = 1
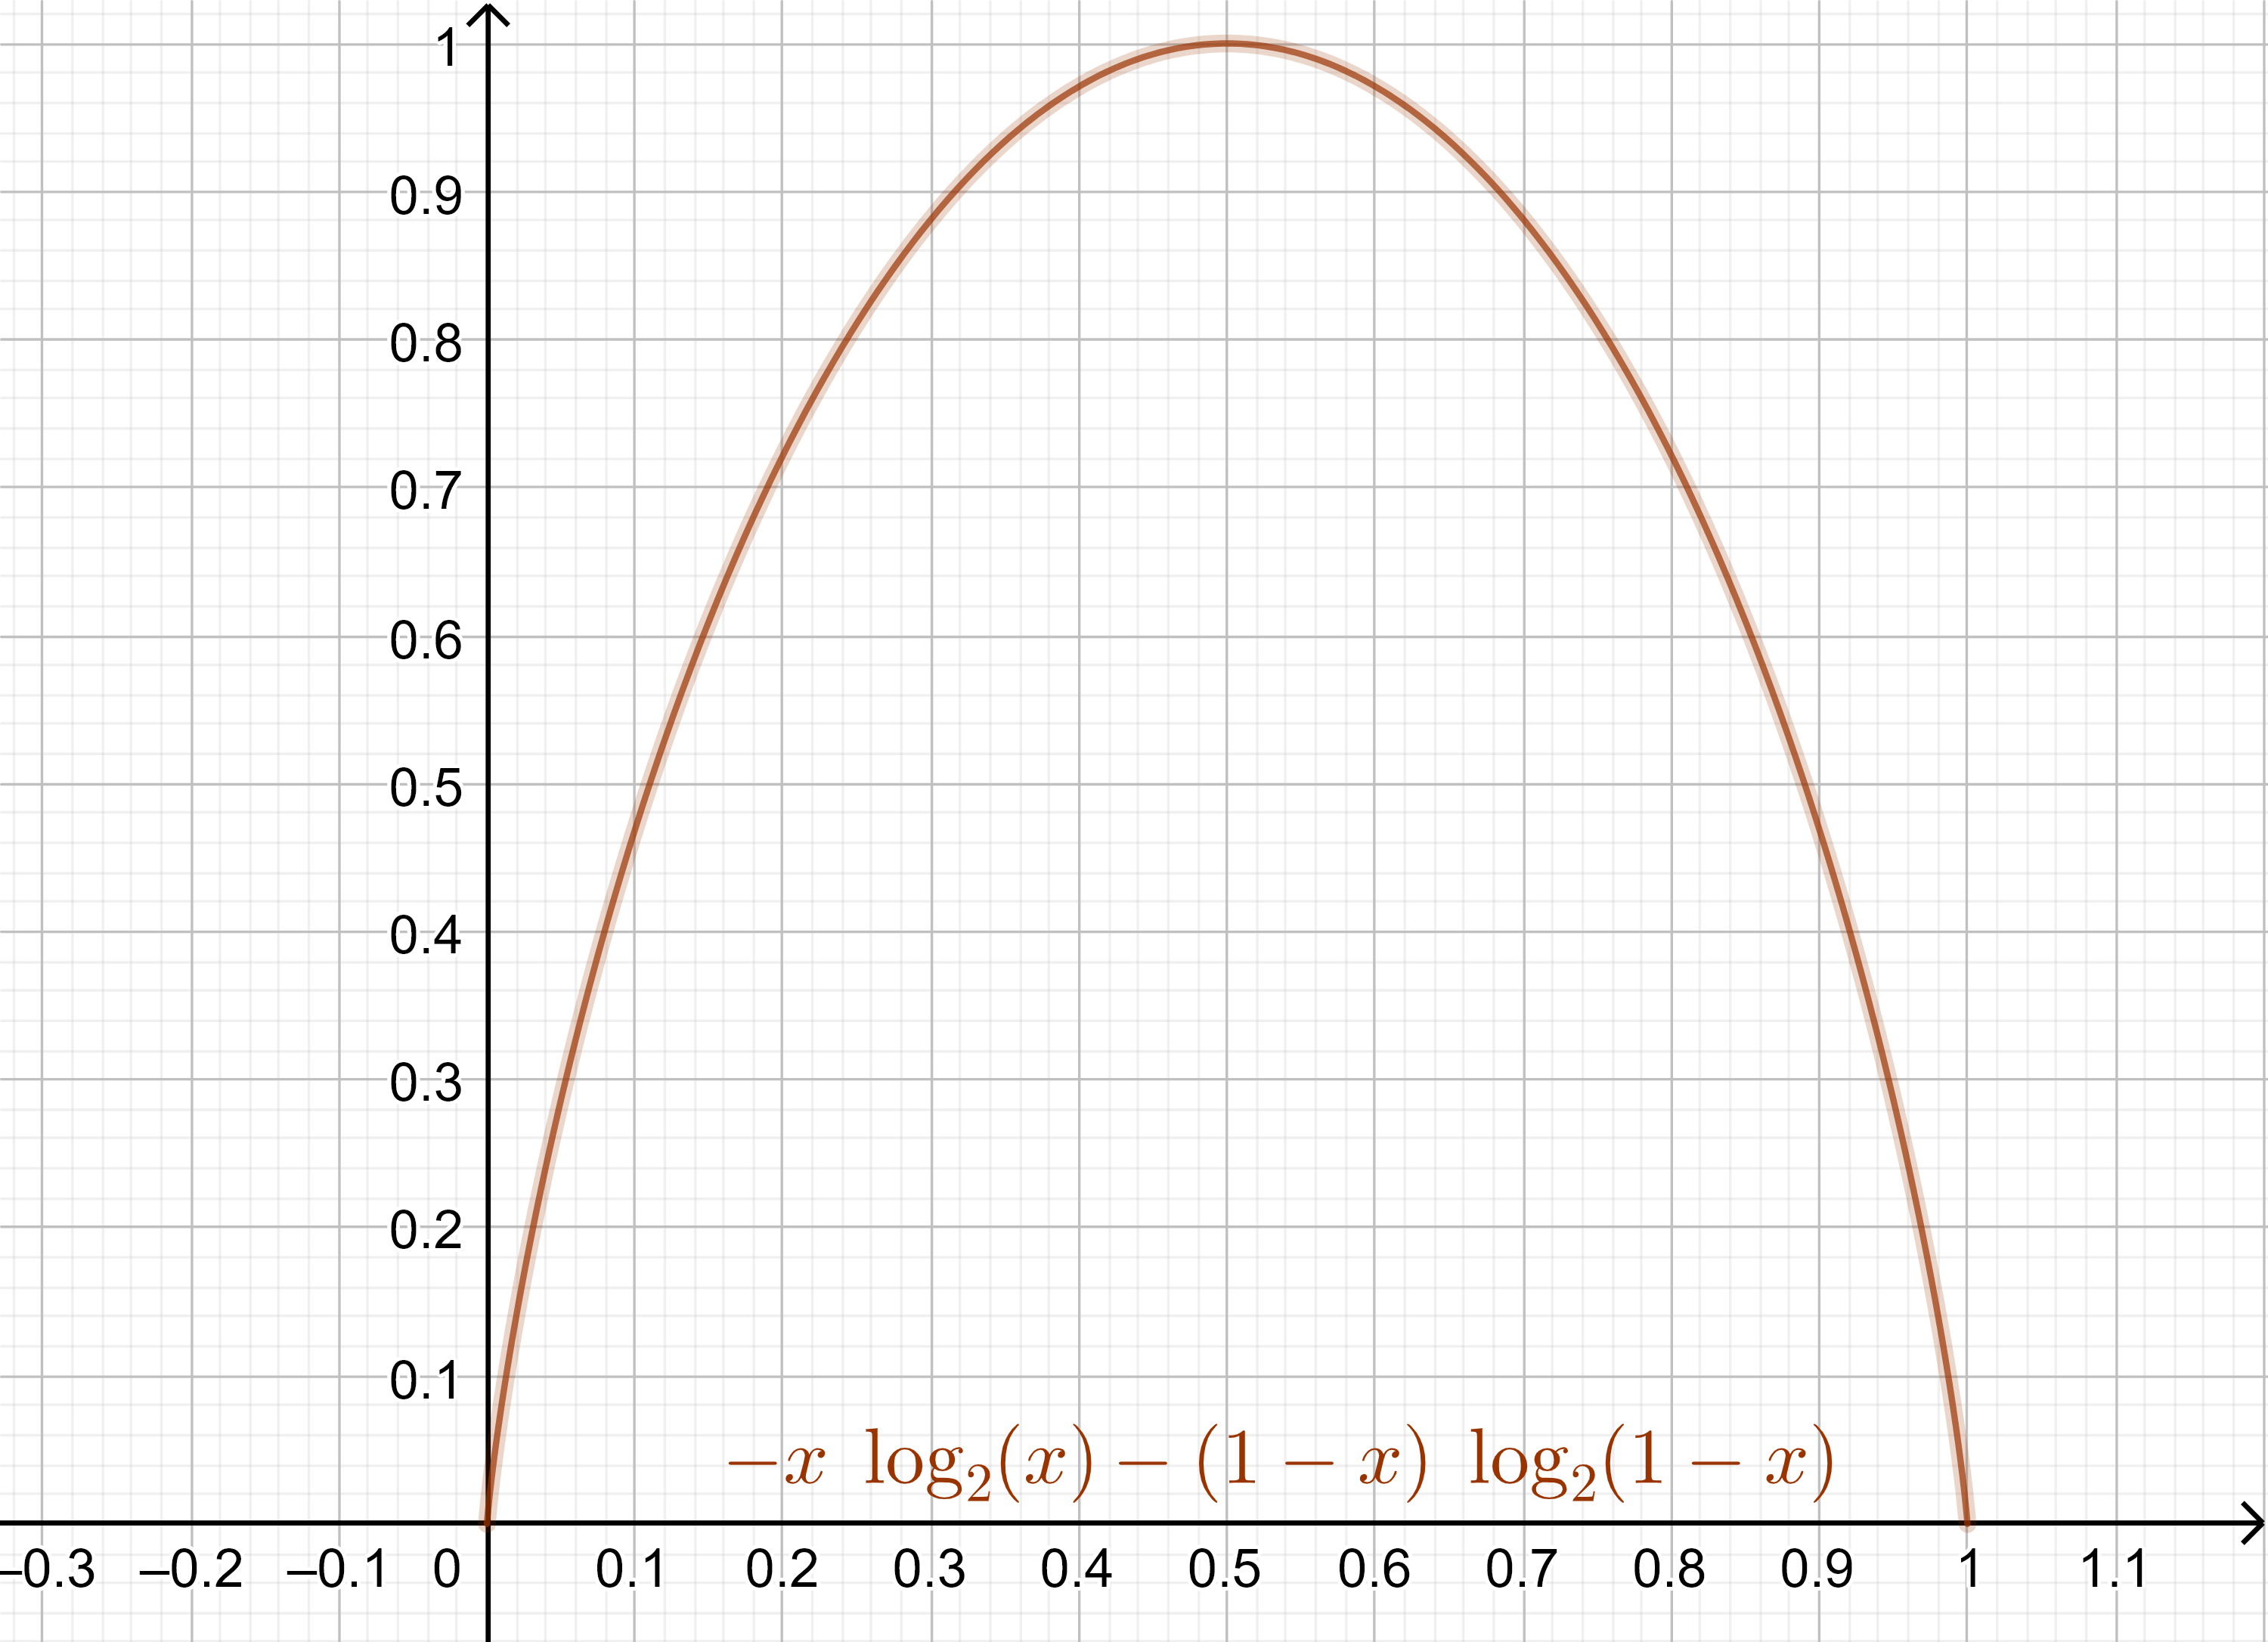
The binary entropy function H ( p ) \mathbf{H}(p) H ( p ) X X X 1 1 1 p p p
H ( p ) = p log 2 1 p + ( 1 − p ) log 2 1 1 − p = − p log 2 p − ( 1 − p ) log 2 ( 1 − p )
\begin{aligned}
\mathbf{H}(p) = &p \log_2 \frac{1}{p} + (1 - p) \log_2 \frac{1}{1 - p} \\
= &-p \log_2 p - (1 - p) \log_2 (1 - p)
\end{aligned}
H ( p ) = = p log 2 p 1 + ( 1 − p ) log 2 1 − p 1 − p log 2 p − ( 1 − p ) log 2 ( 1 − p ) By concavity of log 2 ( ⋅ ) \log_2(\cdot ) log 2 ( ⋅ )
H ( p ) ≤ log 2 ( p 1 p + ( 1 − p ) 1 1 − p ) = 1
\begin{aligned}
\mathbf{H}(p)
&\le \log_2 \left( p \frac{1}{p} + (1 - p) \frac{1}{1 - p} \right)
&= 1
\end{aligned}
H ( p ) ≤ log 2 ( p p 1 + ( 1 − p ) 1 − p 1 ) = 1 The equality holds when p = 0.5 p = 0.5 p = 0.5
Some interesting values:
p = 0.5 p = 0.5 p = 0.5 H ( p ) = 1 \mathbf{H}(p) = 1 H ( p ) = 1 p = 0.2 / 0.8 p = 0.2/0.8 p = 0.2/0.8 H ( p ) ≈ 0.7 \mathbf{H}(p) \approx 0.7 H ( p ) ≈ 0.7 p = 0.1 / 0.9 p = 0.1/0.9 p = 0.1/0.9 H ( p ) ≈ 0.5 \mathbf{H}(p) \approx 0.5 H ( p ) ≈ 0.5
Lemma. Given a discrete range U \mathcal{U} U X X X U \mathcal{U} U X X X
H ( X ) ≤ log ∣ U ∣
\mathbf{H} (X) \le \log |\mathcal{U}|
H ( X ) ≤ log ∣ U ∣
Proof.
H ( X ) = ∑ x p ( x ) log 1 p ( x ) ≤ log ∑ x p ( x ) 1 p ( x ) = log ∣ U ∣
\begin{aligned}
\mathbf{H} (X)
&= \sum_{x} p(x) \log \frac{1}{p(x) } \\
&\le \log \sum_{x} p(x) \frac{1}{p(x) } \\
&= \log |\mathcal{U}|
\end{aligned}
H ( X ) = x ∑ p ( x ) log p ( x ) 1 ≤ log x ∑ p ( x ) p ( x ) 1 = log ∣ U ∣ The inequality holds with equality only when p ( x ) = 1 / ∣ U ∣ p(x) = 1/ |\mathcal{U}| p ( x ) = 1/∣ U ∣
■ \blacksquare ■
Lemma. Let p ( x ) p(x) p ( x ) q ( x ) q(x) q ( x ) λ ∈ [ 0 , 1 ] \lambda \in [0, 1] λ ∈ [ 0 , 1 ]
H ( λ p ( x ) + ( 1 − λ ) q ( x ) ) ≥ λ H ( p ( x ) ) + ( 1 − λ ) H ( q ( x ) )
\mathbf{H} (\lambda p(x) + (1 - \lambda) q(x) ) \ge \lambda \mathbf{H}(p(x) ) + (1 - \lambda) \mathbf{H} (q(x) )
H ( λ p ( x ) + ( 1 − λ ) q ( x )) ≥ λ H ( p ( x )) + ( 1 − λ ) H ( q ( x ))
Proof.
λ H ( p ( x ) ) + ( 1 − λ ) H ( q ( x ) ) = ∑ x ( λ p ( x ) log 1 p ( x ) + ( 1 − λ ) q ( x ) log 1 q ( x ) ) = ( λ p ( x ) + ( 1 − λ ) q ( x ) ) ∑ x ( λ p ( x ) λ p ( x ) + ( 1 − λ ) q ( x ) log 1 p ( x ) + ( 1 − λ ) q ( x ) λ p ( x ) + ( 1 − λ ) q ( x ) log 1 q ( x ) ) ≤ ∑ x ( λ p ( x ) + ( 1 − λ ) q ( x ) ) log 1 λ p ( x ) + ( 1 − λ ) q ( x ) = H ( λ p ( x ) + ( 1 − λ ) q ( x ) )
\begin{aligned}
\lambda \mathbf{H}(p(x) ) + (1 - \lambda) \mathbf{H} (q(x) )
&= \sum_{x} \left( \lambda p(x) \log \frac{1}{p(x)} + (1 - \lambda) q(x) \log \frac{1}{q(x) } \right) \\
&= ( \lambda p(x) + (1 - \lambda) q(x) )\sum_{x} \left( \frac{ \lambda p(x) }{ \lambda p(x) + (1 - \lambda) q(x) } \log \frac{1}{p(x)} + \frac{(1 - \lambda) q(x) }{ \lambda p(x) + (1 - \lambda) q(x) } \log \frac{1}{q(x) } \right) \\
&\le \sum_{x} ( \lambda p(x) + (1 - \lambda) q(x) ) \log \frac{1}{ \lambda p(x) + (1 - \lambda) q(x) } \\
&= \mathbf{H} ( \lambda p(x) + (1 - \lambda) q(x) )
\end{aligned}
λ H ( p ( x )) + ( 1 − λ ) H ( q ( x )) = x ∑ ( λ p ( x ) log p ( x ) 1 + ( 1 − λ ) q ( x ) log q ( x ) 1 ) = ( λ p ( x ) + ( 1 − λ ) q ( x )) x ∑ ( λ p ( x ) + ( 1 − λ ) q ( x ) λ p ( x ) log p ( x ) 1 + λ p ( x ) + ( 1 − λ ) q ( x ) ( 1 − λ ) q ( x ) log q ( x ) 1 ) ≤ x ∑ ( λ p ( x ) + ( 1 − λ ) q ( x )) log λ p ( x ) + ( 1 − λ ) q ( x ) 1 = H ( λ p ( x ) + ( 1 − λ ) q ( x )) ■ \blacksquare ■
Lemma. For two independent random variables X X X Y Y Y
E [ log 2 1 Pr [ X + Y ] ] = E [ log 2 1 Pr [ X ] ] + E [ log 2 1 Pr [ Y ] ] ,
\mathbb{E} \left[ \log_2 \frac{1}{\Pr[X + Y] } \right] = \mathbb{E} \left[ \log_2 \frac{1}{\Pr[X] } \right] + \mathbb{E} \left[ \log_2 \frac{1}{\Pr[Y] } \right],
E [ log 2 Pr [ X + Y ] 1 ] = E [ log 2 Pr [ X ] 1 ] + E [ log 2 Pr [ Y ] 1 ] , i.e.,
H [ X + Y ] = H [ X ] + H [ Y ] .
\mathbf{H}[X + Y] = \mathbf{H}[X] + \mathbf{H}[Y].
H [ X + Y ] = H [ X ] + H [ Y ] .
Proof. We prove it for the case of discrete random variables.
E [ log 2 1 Pr [ X + Y ] ] = ∑ x , y p ( x , y ) log 2 1 p ( x , y ) = ∑ x , y p ( x ) p ( y ) ( log 2 1 p ( x ) + log 2 1 p ( y ) ) = ∑ x p ( x ) ∑ y p ( y ) log 2 1 p ( x ) + ∑ y p ( y ) ∑ x p ( x ) log 2 1 p ( y ) = E [ log 2 1 Pr [ X ] ] + E [ log 2 1 Pr [ Y ] ]
\begin{array}{rrl}
&\mathbb{E} \left[ \log_2 \frac{1}{\Pr[X + Y] } \right]
&= \sum_{x, y} p(x, y) \log_2 \frac{1}{p(x, y)} \\
&&= \sum_{x, y} p(x) p(y) \left( \log_2 \frac{1}{p(x)} + \log_2 \frac{1}{p(y) } \right) \\
&&= \sum_{x} p(x) \sum_{y} p(y) \log_2 \frac{1}{p(x)} + \sum_{y} p(y) \sum_{x} p(x) \log_2 \frac{1}{p(y) } \\
&&= \mathbb{E} \left[ \log_2 \frac{1}{\Pr[X] } \right] + \mathbb{E} \left[ \log_2 \frac{1}{\Pr[Y] } \right]
\end{array}
E [ log 2 P r [ X + Y ] 1 ] = ∑ x , y p ( x , y ) log 2 p ( x , y ) 1 = ∑ x , y p ( x ) p ( y ) ( log 2 p ( x ) 1 + log 2 p ( y ) 1 ) = ∑ x p ( x ) ∑ y p ( y ) log 2 p ( x ) 1 + ∑ y p ( y ) ∑ x p ( x ) log 2 p ( y ) 1 = E [ log 2 P r [ X ] 1 ] + E [ log 2 P r [ Y ] 1 ] ■ \blacksquare ■
Joint Entropy and Conditional Entropy
Definition. Given random variable X X X Y Y Y H ( X , Y ) \mathbf{H}(X, Y) H ( X , Y ) p ( x , y ) p(x, y) p ( x , y )
H ( X , Y ) = E [ log 1 p ( x , y ) ] .
\mathbf{H}(X,Y) = \mathbb{E}\left[ \log \frac{1}{p(x, y)} \right].
H ( X , Y ) = E [ log p ( x , y ) 1 ] . When X X X Y Y Y
H ( X , Y ) = ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 1 p ( x , y ) .
\mathbf{H}(X,Y) = \sum_{x \in \mathcal{X} } \sum_{y \in \mathcal{Y} } p(x, y) \log \frac{1}{p(x, y) }.
H ( X , Y ) = x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log p ( x , y ) 1 .
Definition. The conditional entropy H ( Y ∣ X ) \mathbf{H}(Y \mid X) H ( Y ∣ X ) p ( x , y ) p(x, y) p ( x , y )
H ( Y ∣ X ) = ∑ x ∈ X p ( x ) ⋅ H ( Y ∣ X = x ) = ∑ x ∈ X p ( x ) ⋅ ∑ y ∈ Y p ( y ∣ x ) log 1 p ( y ∣ x ) = ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 1 p ( y ∣ x ) = E [ log 1 p ( y ∣ x ) ]
\begin{aligned}
\mathbf{H}(Y \mid X)
&= \sum_{x \in \mathcal{X} } p(x) \cdot \mathbf{H} (Y \mid X = x) \\
&= \sum_{x \in \mathcal{X} } p(x) \cdot \sum_{y \in \mathcal{Y} } p(y \mid x) \log \frac{1}{p(y \mid x) } \\
&= \sum_{x \in \mathcal{X} } \sum_{y \in \mathcal{Y} } p(x, y) \log \frac{1}{p(y \mid x) } \\
&= \mathbb{E} \left[ \log \frac{1}{p(y \mid x) } \right]
\end{aligned}
H ( Y ∣ X ) = x ∈ X ∑ p ( x ) ⋅ H ( Y ∣ X = x ) = x ∈ X ∑ p ( x ) ⋅ y ∈ Y ∑ p ( y ∣ x ) log p ( y ∣ x ) 1 = x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log p ( y ∣ x ) 1 = E [ log p ( y ∣ x ) 1 ]
Remark. Conditioned on X = x X = x X = x Y Y Y H ( Y ∣ X = x ) \mathbf{H}(Y \mid X = x) H ( Y ∣ X = x ) H ( Y ∣ X ) \mathbf{H}(Y \mid X) H ( Y ∣ X ) H ( Y ∣ X = x ) \mathbf{H}(Y \mid X = x) H ( Y ∣ X = x ) X X X Y Y Y X X X H ( Y ∣ X ) \mathbf{H}(Y \mid X) H ( Y ∣ X ) H ( Y ∣ X = x ) \mathbf{H}(Y \mid X = x) H ( Y ∣ X = x ) E [ Y ∣ X ] \mathbb{E}[Y \mid X] E [ Y ∣ X ] E [ Y ∣ X = x ] \mathbb{E}[Y \mid X = x] E [ Y ∣ X = x ]
Chain Rule. For random variable X X X Y Y Y
H ( X , Y ) = ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 1 p ( x , y ) = ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 1 p ( y ∣ x ) p ( x ) = ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 1 p ( y ∣ x ) + ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 1 p ( x ) = H ( Y ∣ X ) + H ( X )
\begin{aligned}
\mathbf{H}(X, Y)
&= \sum_{x \in \mathcal{X} } \sum_{y \in \mathcal{Y} } p(x, y) \log \frac{1}{p(x, y) } \\
&= \sum_{x \in \mathcal{X} } \sum_{y \in \mathcal{Y} } p(x, y) \log \frac{1}{p(y \mid x) p(x) } \\
&= \sum_{x \in \mathcal{X} } \sum_{y \in \mathcal{Y} } p(x, y) \log \frac{1}{p(y \mid x) } + \sum_{x \in \mathcal{X} } \sum_{y \in \mathcal{Y} } p(x, y) \log \frac{1}{ p(x) } \\
&= \mathbf{H}(Y \mid X) + \mathbf{H}(X)
\end{aligned}
H ( X , Y ) = x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log p ( x , y ) 1 = x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log p ( y ∣ x ) p ( x ) 1 = x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log p ( y ∣ x ) 1 + x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log p ( x ) 1 = H ( Y ∣ X ) + H ( X )
Corollaries
H ( X ) + H ( Y ∣ X ) = H ( Y ) + H ( X ∣ Y )
\mathbf{H}(X) + \mathbf{H}(Y \mid X) =
\mathbf{H}(Y) + \mathbf{H}(X \mid Y)
H ( X ) + H ( Y ∣ X ) = H ( Y ) + H ( X ∣ Y ) Or
H ( X ) − H ( X ∣ Y ) = H ( Y ) − H ( Y ∣ X )
\mathbf{H}(X) - \mathbf{H}(X \mid Y)=
\mathbf{H}(Y) - \mathbf{H}(Y \mid X)
H ( X ) − H ( X ∣ Y ) = H ( Y ) − H ( Y ∣ X ) Binomial Distribution
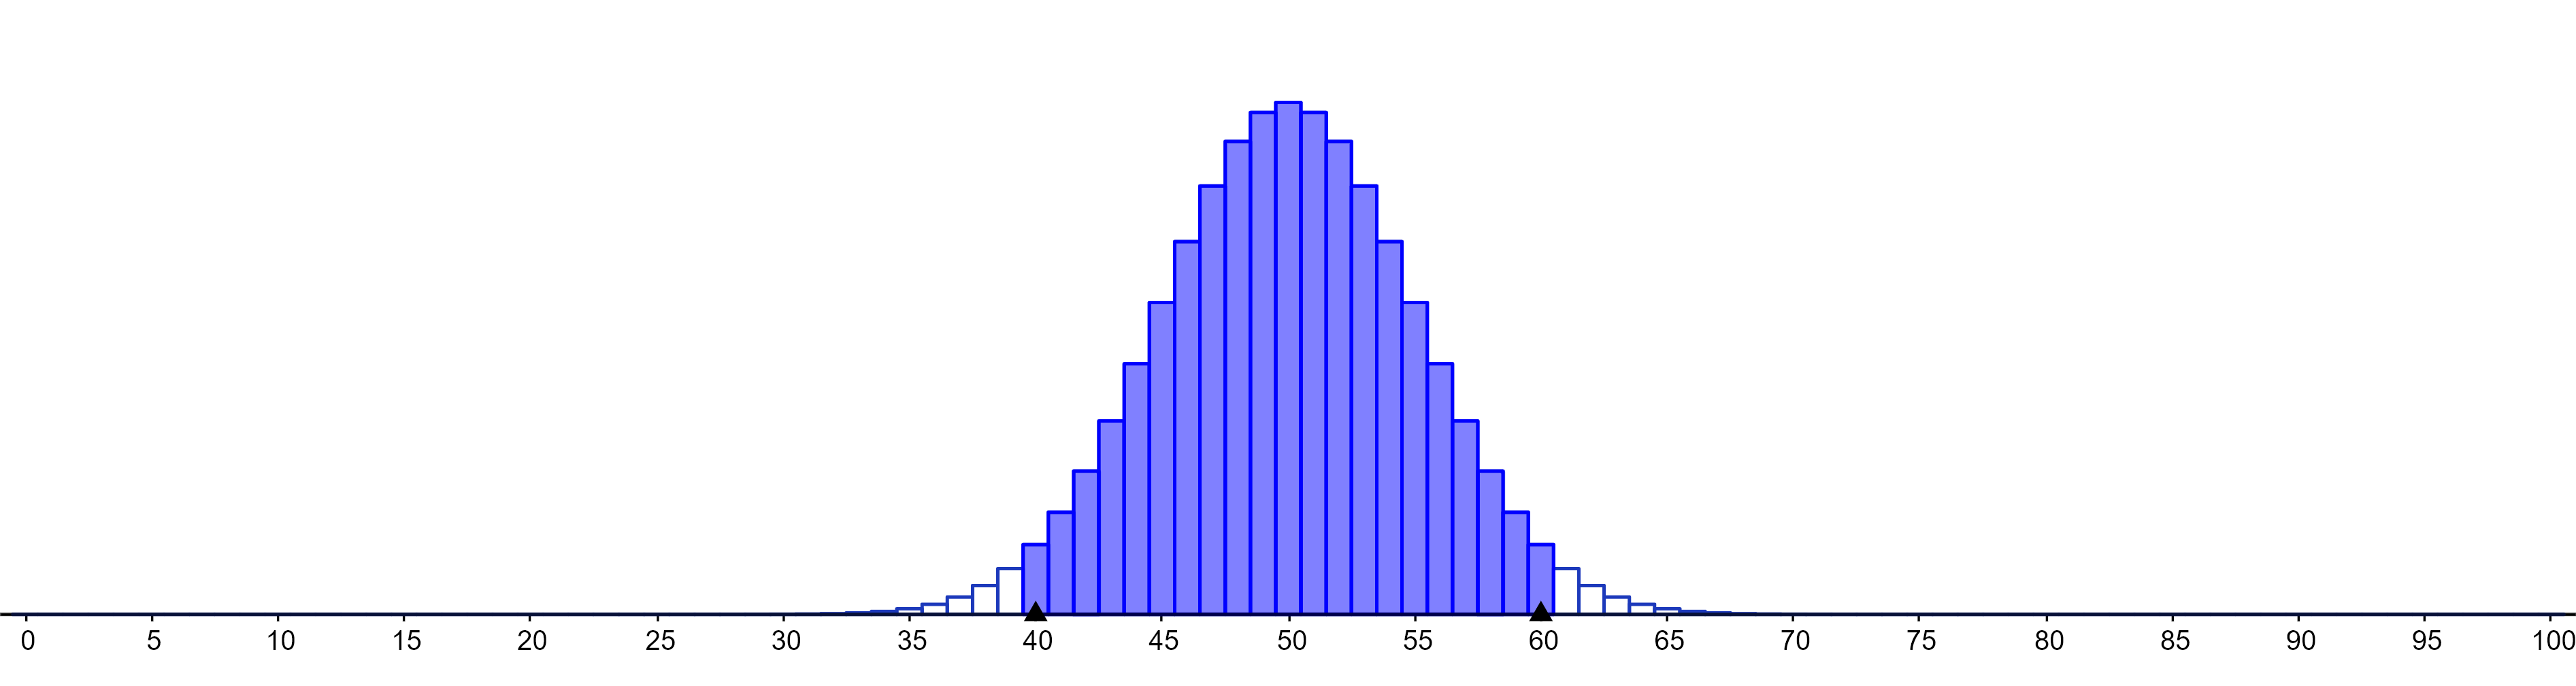
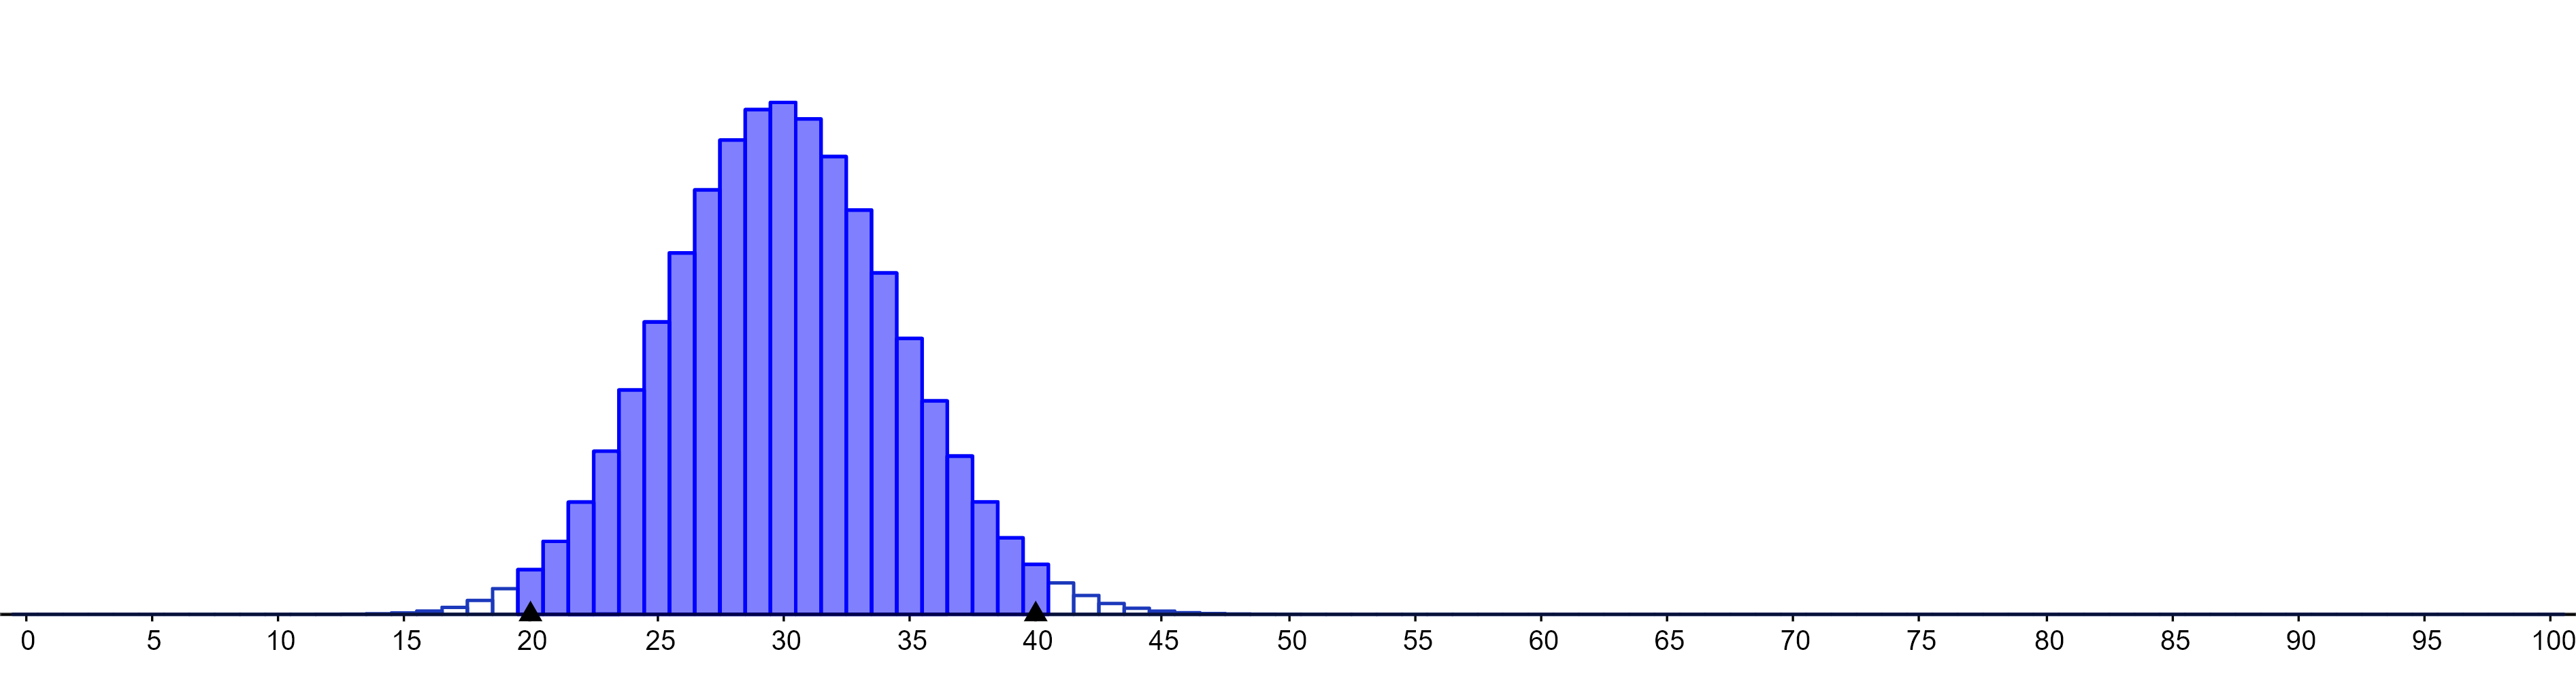
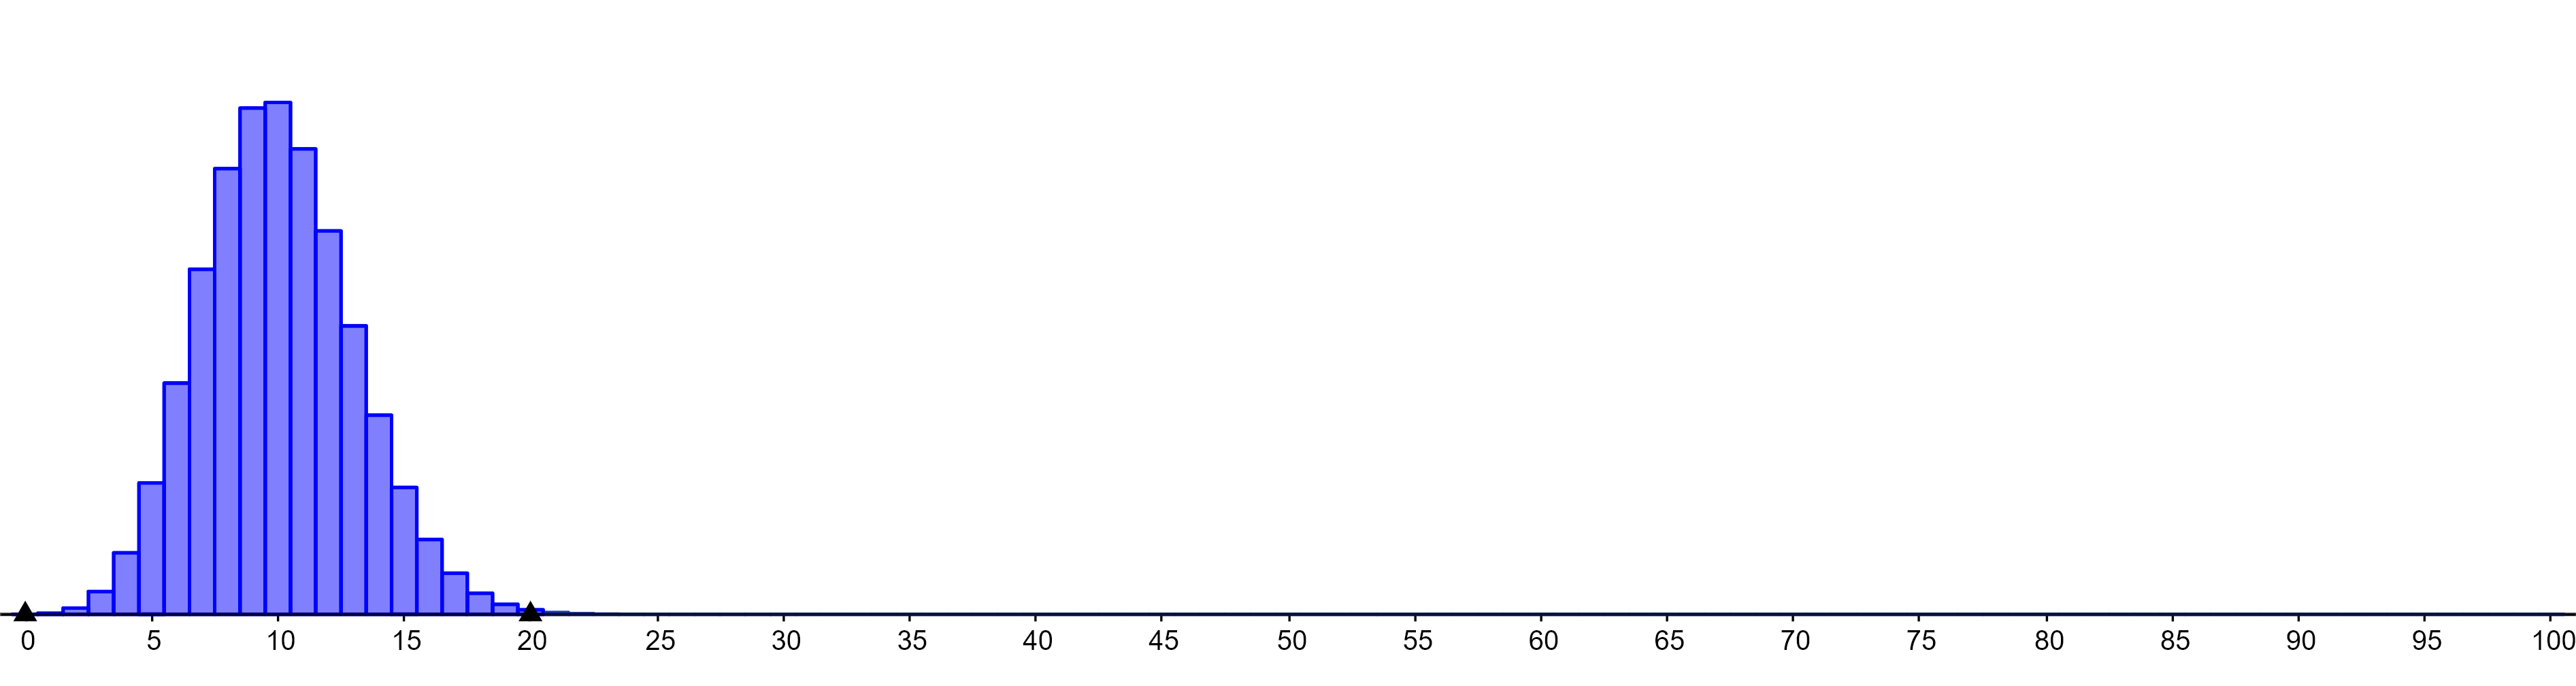
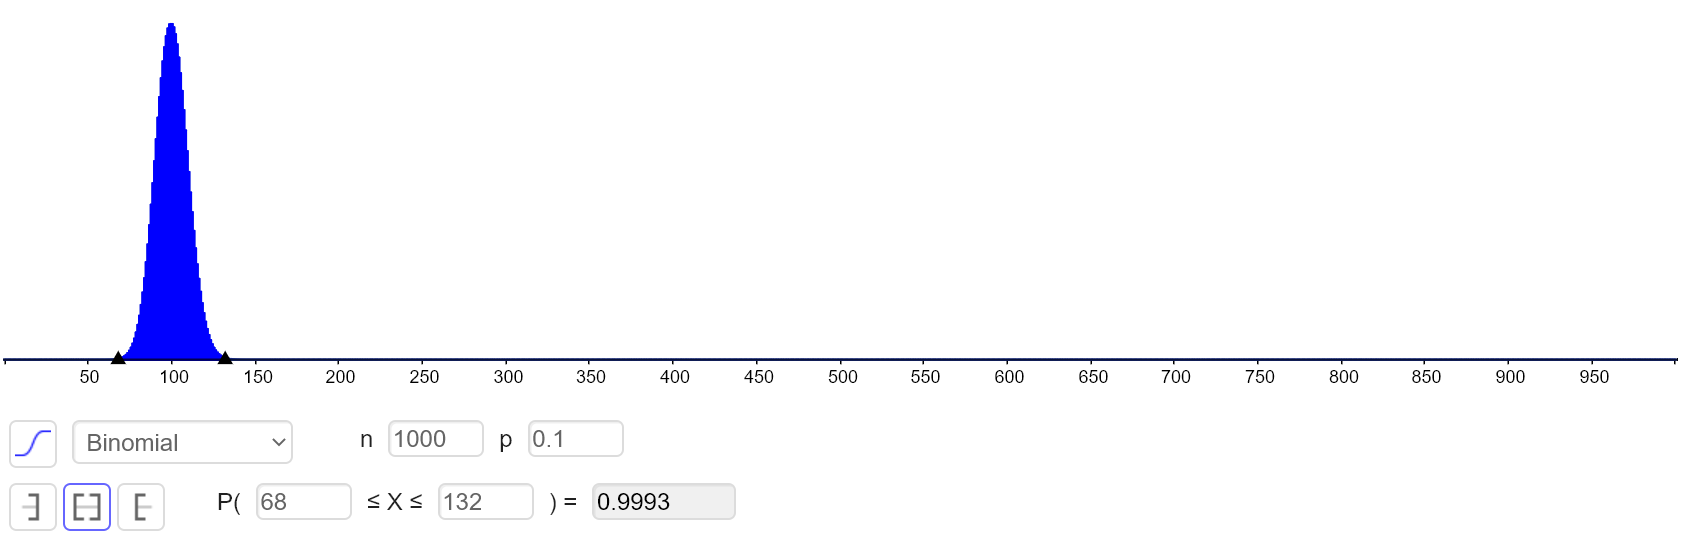
We study the relationship of binomial distribution B ( n , p ) B(n, p) B ( n , p ) n n n n ≥ 100 n \ge 100 n ≥ 100 p p p 0.1 ≤ p ≤ 0.9 0.1 \le p \le 0.9 0.1 ≤ p ≤ 0.9 [ n p − n , n p + n ] [np - \sqrt n, np + \sqrt n] [ n p − n , n p + n ]
N = 100 , p = 0.5 N = 100, p = 0.5 N = 100 , p = 0.5
N = 100 , p = 0.3 N = 100, p = 0.3 N = 100 , p = 0.3
N = 100 , p = 0.1 N = 100, p = 0.1 N = 100 , p = 0.1
N = 1000 , p = 0.1 N = 1000, p = 0.1 N = 1000 , p = 0.1
Pr [ 100 − 1000 ≤ X ≤ 100 + 1000 ] ≈ 0.9993
\Pr[ 100 - \sqrt{1000} \le X \le 100 + \sqrt{1000} ] \approx 0.9993
Pr [ 100 − 1000 ≤ X ≤ 100 + 1000 ] ≈ 0.9993
Lemma .n ∈ Z + n\in \mathbf{Z}^+ n ∈ Z + k ∈ [ n ] k \in [n] k ∈ [ n ]
( n k ) ≥ 1 n + 1 2 n H ( k n )
\binom{n}{k} \ge \frac{1}{n + 1} 2^{n \mathbf{H}(\frac{k}{n} ) }
( k n ) ≥ n + 1 1 2 n H ( n k ) Proof .q = k n q = \frac{k}{n} q = n k
( q + ( 1 − q ) ) n = ∑ i = 0 n ( n i ) q i ( 1 − q ) n − i
\begin{aligned}
(q + (1 - q))^n &= \sum_{i = 0}^n \binom{n}{i} q^i (1 - q)^{n - i}
\end{aligned}
( q + ( 1 − q ) ) n = i = 0 ∑ n ( i n ) q i ( 1 − q ) n − i The summation consists of ( n + 1 ) (n + 1) ( n + 1 )
( n k ) q k ( 1 − q ) n − k
\binom{n}{k} q^k (1 - q)^{n - k}
( k n ) q k ( 1 − q ) n − k is the largest one. For i ∈ [ n ] i \in [n] i ∈ [ n ]
( n i + 1 ) q i + 1 ( 1 − q ) n − i − 1 ( n i ) q i ( 1 − q ) n − i = n − i i + 1 q 1 − q
\frac{ \binom{n}{i + 1} q^{i + 1} (1 - q)^{n - i - 1} }{ \binom{n}{i } q^{i} (1 - q)^{n - i } } = \frac{n - i }{i + 1} \frac{ q}{1 - q}
( i n ) q i ( 1 − q ) n − i ( i + 1 n ) q i + 1 ( 1 − q ) n − i − 1 = i + 1 n − i 1 − q q The ratio is at least 1 1 1 n − i i + 1 ≥ 1 − q q \frac{n - i}{i + 1} \ge \frac{1 - q}{ q } i + 1 n − i ≥ q 1 − q i = n q − 1 = k − 1 i = nq - 1 = k - 1 i = n q − 1 = k − 1
n − i i + 1 = n − n q + 1 n q ≥ 1 − q q
\frac{n - i}{i + 1} = \frac{n - nq + 1}{ n q} \ge \frac{1 - q}{ q }
i + 1 n − i = n q n − n q + 1 ≥ q 1 − q and when i = k i = k i = k
n − i i + 1 = n − n q n q + 1 < 1 − q q
\frac{n - i}{i + 1} = \frac{n - nq}{ n q + 1} < \frac{1 - q}{ q }
i + 1 n − i = n q + 1 n − n q < q 1 − q Therefore,
( n k ) q k ( 1 − q ) n − k = ( n k ) 2 k log 2 q 2 ( n − k ) log 2 ( 1 − q ) = ( n k ) 2 n [ q log 2 q + ( 1 − q ) log 2 ( 1 − q ) ] ≥ 1 n + 1
\begin{aligned}
\binom{n}{k} q^k (1 - q)^{n - k}
&= \binom{n}{k} 2^{k \log_2 q} 2^{ (n - k )\log_2 (1 - q)} \\
&= \binom{n}{k} 2^{ n [ q \log_2 q + (1 - q )\log_2 (1 - q) ]} \\
&\ge \frac{1}{n + 1}
\end{aligned}
( k n ) q k ( 1 − q ) n − k = ( k n ) 2 k l o g 2 q 2 ( n − k ) l o g 2 ( 1 − q ) = ( k n ) 2 n [ q l o g 2 q + ( 1 − q ) l o g 2 ( 1 − q )] ≥ n + 1 1 ■ \blacksquare ■
Extracting Random Bits
Consider a uniform random variable X X X [ 0 , m − 1 ] [0, m - 1] [ 0 , m − 1 ]
H [ X ] = ∑ i = 0 m − 1 1 m log 2 1 1 m = log 2 m
\mathbf{H}[X] = \sum_{i = 0}^{m - 1} \frac{1}{m} \log_2 \frac{1}{\frac{1}{m} } = \log_2 m
H [ X ] = i = 0 ∑ m − 1 m 1 log 2 m 1 1 = log 2 m Given X X X s s s s s s 0.5 0.5 0.5
On the high level, we divide m m m X X X
m = 2 d k + 2 d k − 1 + . . . + 2 d 1
m = 2^{d_k} + 2^{d_{k - 1} } + ... + 2^{d_1}
m = 2 d k + 2 d k − 1 + ... + 2 d 1 where ⌊ H [ X ] ⌋ = ⌊ log 2 m ⌋ = d k > d k − 1 > . . . > d 1 ≥ 0 \lfloor \mathbf{H}[X] \rfloor = \lfloor \log_2 m \rfloor = d_k > d_{k - 1} > ... > d_1 \ge 0 ⌊ H [ X ]⌋ = ⌊ log 2 m ⌋ = d k > d k − 1 > ... > d 1 ≥ 0 m m m
Algorithm 1.
for i ← k i \leftarrow k i ← k down-to 1 1 1 do :
\quad if X < 2 d i X < 2^{d_i} X < 2 d i then :\quad \quad return a d i d_i d i X X X \quad else: \quad \quad X ← X − 2 d i X \leftarrow X - 2^{d_i} X ← X − 2 d i
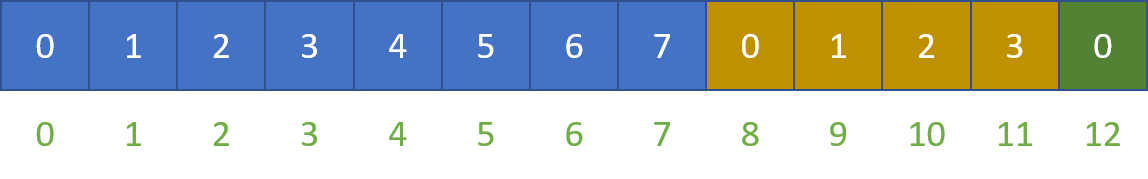
Example (m = 13 m = 13 m = 13
It is interesting to note that when X = 12 X = 12 X = 12 0 < 2 0 0 < 2^0 0 < 2 0
Question to ponder: Come up with some method that uses n n n X X X n H [ X ] n \mathbf{H}[X] n H [ X ]
Let s s s
Theorem 1
⌊ log 2 m ⌋ − 1 ≤ E [ ∣ s ∣ ] ≤ log 2 m
\lfloor \log_2 m \rfloor - 1 \le \mathbf{E}[|s|] \le \log_2 m
⌊ log 2 m ⌋ − 1 ≤ E [ ∣ s ∣ ] ≤ log 2 m Proof. It is easy to see that
E [ ∣ s ∣ ] = ∑ i = 1 k d i 2 d i m
\mathbf{E}[|s| ] = \sum_{i = 1}^k d_i \frac{2^{d_i} }{m }
E [ ∣ s ∣ ] = i = 1 ∑ k d i m 2 d i which depends on m m m
∑ i = 1 k d i 2 d i m − log 2 m = ∑ i = 1 k 2 d i m log 2 2 d i m ≤ 0
\begin{array}{lll}
\sum_{i = 1}^k d_i \frac{2^{d_i} }{m } - \log_2 m
= \sum_{i = 1}^k \frac{2^{d_i} }{m } \log_2 \frac{2^{d_i} }{m } \le 0
\end{array}
∑ i = 1 k d i m 2 d i − log 2 m = ∑ i = 1 k m 2 d i log 2 m 2 d i ≤ 0 The inequality follows from log 2 2 d i m ≤ 0 \log_2 \frac{2^{d_i} }{m } \le 0 log 2 m 2 d i ≤ 0 1 ≤ i ≤ k 1 \le i \le k 1 ≤ i ≤ k
To show the lower bound, define the function
f ( m ) = ∑ i = 1 k d i 2 d i m
f(m) = \sum_{i = 1}^k d_i \frac{2^{d_i} }{m }
f ( m ) = i = 1 ∑ k d i m 2 d i We prove by induction on m m m f ( m ) ≥ ⌊ log 2 m ⌋ − 1 = d k − 1 f(m) \ge \lfloor \log_2 m \rfloor - 1 = d_k - 1 f ( m ) ≥ ⌊ log 2 m ⌋ − 1 = d k − 1 m = 1 m = 1 m = 1 m m m m m m
Case 1. m = 2 d k m = 2^{d_k} m = 2 d k f ( m ) = d k = log 2 m f(m) = d_k = \log_2 m f ( m ) = d k = log 2 m
Case 2. m > 2 d k m > 2^{d_k} m > 2 d k
f ( m ) = ∑ i = 1 k d i 2 d i m = d k 2 d k m + ( ∑ i = 1 k − 1 d i 2 d i m − 2 d k ) m − 2 d k m
\begin{aligned}
f(m) &= \sum_{i = 1}^k d_i \frac{2^{d_i} }{m } \\
&= d_k \frac{2^{d_k} }{m} + \left( \sum_{i = 1}^{k - 1} d_i \frac{2^{d_i} }{m - 2^{d_k} } \right) \frac{m - 2^{d_k} }{m} \\
\end{aligned}
f ( m ) = i = 1 ∑ k d i m 2 d i = d k m 2 d k + ( i = 1 ∑ k − 1 d i m − 2 d k 2 d i ) m m − 2 d k But ∑ i = 1 k − 1 2 d i = m − 2 d k \sum_{i = 1}^{k - 1} 2^{d_i} = m - 2^{d_k} ∑ i = 1 k − 1 2 d i = m − 2 d k
∑ i = 1 k − 1 d i 2 d i m − 2 d k = f ( m − 2 d k ) ≥ d k − 1 − 1
\sum_{i = 1}^{k - 1} d_i \frac{2^{d_i} }{m - 2^{d_k} } = f(m - 2^{d_k}) \ge d_{k - 1} - 1
i = 1 ∑ k − 1 d i m − 2 d k 2 d i = f ( m − 2 d k ) ≥ d k − 1 − 1 Finally,
f ( m ) ≥ d k 2 d k m + ( d k − 1 − 1 ) m − 2 d k m = d k + ( d k − 1 − d k − 1 ) m − 2 d k m = d k − ( d k + 1 − d k − 1 ) ( 1 − 2 d k m ) ≥ d k − ( d k + 1 − d k − 1 ) ( 1 − 2 d k 2 d k + 2 d k − 1 ) = d k − ( d k + 1 − d k − 1 ) ( 2 d k − 1 2 d k + 2 d k − 1 ) = d k − ( d k − d k − 1 + 1 2 d k − d k − 1 + 1 ) ≥ d k − ( d k − d k − 1 + 1 2 d k − d k − 1 ) ≥ d k − 1
\begin{aligned}
f(m)
&\ge d_k \frac{2^{d_k} }{m} + \left( d_{k - 1} -1 \right) \frac{m - 2^{d_k} }{m} \\
&= d_k + \left( d_{k - 1}- d_k -1 \right) \frac{m - 2^{d_k} }{m} \\
&= d_k - \left( d_k + 1 - d_{k - 1} \right) \left( 1 - \frac{ 2^{d_k} }{m} \right)\\
&\ge d_k - \left( d_k + 1 - d_{k - 1} \right) \left( 1 - \frac{ 2^{d_k} }{2^{d_k} + 2^{d_{k - 1} } } \right)\\
&= d_k - \left( d_k + 1 - d_{k - 1} \right) \left( \frac{ 2^{d_{k - 1} } }{2^{d_k} + 2^{d_{k - 1} } } \right)\\
&= d_k - \left( \frac{ d_k - d_{k - 1} + 1 }{2^{d_k - d_{k - 1} } + 1 } \right)\\
&\ge d_k - \left( \frac{ d_k - d_{k - 1} + 1 }{2^{d_k - d_{k - 1} } } \right)\\
&\ge d_k - 1
\end{aligned}
f ( m ) ≥ d k m 2 d k + ( d k − 1 − 1 ) m m − 2 d k = d k + ( d k − 1 − d k − 1 ) m m − 2 d k = d k − ( d k + 1 − d k − 1 ) ( 1 − m 2 d k ) ≥ d k − ( d k + 1 − d k − 1 ) ( 1 − 2 d k + 2 d k − 1 2 d k ) = d k − ( d k + 1 − d k − 1 ) ( 2 d k + 2 d k − 1 2 d k − 1 ) = d k − ( 2 d k − d k − 1 + 1 d k − d k − 1 + 1 ) ≥ d k − ( 2 d k − d k − 1 d k − d k − 1 + 1 ) ≥ d k − 1 The last inequality holds since d k − 1 ≤ d k − 1 d_{k - 1} \le d_k - 1 d k − 1 ≤ d k − 1 f ( x ) = x + 1 2 x f(x) = \frac{x + 1}{2^x} f ( x ) = 2 x x + 1 x ≥ 1 x \ge 1 x ≥ 1
■ \blacksquare ■
Binary Strings
To illustrate the idea of entropy, we study another example of random bit extraction.
Problem. Let t t t n n n p ≤ 0.5 p \le 0.5 p ≤ 0.5 t t t s s s n n n
Theorem.
∀ δ ∈ ( 0 , 1 ) \forall \delta \in (0, 1) ∀ δ ∈ ( 0 , 1 ) ∃ N > 0 \exists N > 0 ∃ N > 0 s . t . s.t. s . t . ∀ n ≥ N \forall n \ge N ∀ n ≥ N E [ ∣ s ∣ ] ≥ ( 1 − δ ) n H ( p ) \mathbf{E}[|s|] \ge (1 - \delta) n\mathbf{H}(p) E [ ∣ s ∣ ] ≥ ( 1 − δ ) n H ( p ) ∀ n > 0 \forall n > 0 ∀ n > 0 E [ ∣ s ∣ ] ≤ n H ( p ) \mathbf{E}[|s|] \le n\mathbf{H}(p) E [ ∣ s ∣ ] ≤ n H ( p )
The theorem states that the expected length of s s s n H ( p ) n\mathbf{H}(p) n H ( p )
lim n → ∞ E [ ∣ s ∣ ] n = H ( p )
\lim_{n \rightarrow \infty} \frac{\mathbf{E}[|s|]}{n} = \mathbf{H}(p)
n → ∞ lim n E [ ∣ s ∣ ] = H ( p ) Proof. Z Z Z t t t k ≥ 0 k \ge 0 k ≥ 0 ( n k ) \binom{n}{k} ( k n ) k k k { 0 , 1 , . . . , ( n k ) − 1 } \{0, 1, ..., \binom{n}{k} - 1 \} { 0 , 1 , ... , ( k n ) − 1 } Z = k Z = k Z = k t t t { 0 , 1 , . . . , ( n k ) − 1 } \{0, 1, ..., \binom{n}{k} - 1 \} { 0 , 1 , ... , ( k n ) − 1 } s s s
E [ ∣ s ∣ ] = ∑ k = 1 n E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ]
\mathbf{E}[|s|] = \sum_{k = 1}^n \mathbf{E}\left[ |s| \mid Z = k \right] \Pr[Z = k]
E [ ∣ s ∣ ] = k = 1 ∑ n E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] Further, by Hoeffding's inequality, it holds that for 0 < ϵ < p 0 < \epsilon < p 0 < ϵ < p
Pr [ ∣ Z − n p ∣ ≥ n ϵ ] ≤ exp ( − 2 n ϵ 2 )
\Pr[ |Z - np | \ge n\epsilon] \le \exp\left(- 2 n \epsilon^2 \right)
Pr [ ∣ Z − n p ∣ ≥ n ϵ ] ≤ exp ( − 2 n ϵ 2 ) By setting the failure probability exp ( − 2 n ϵ 2 ) = δ / 2 \exp(-2 n \epsilon^2) = \delta / 2 exp ( − 2 n ϵ 2 ) = δ /2 ϵ = ln 2 δ 2 n \epsilon = \sqrt{\frac{\ln \frac{2}{\delta} }{2n} } ϵ = 2 n l n δ 2
Let L B = ⌈ n p − n ϵ ⌉ LB = \lceil np - n\epsilon \rceil L B = ⌈ n p − n ϵ ⌉ U B = ⌊ n p + n ϵ ⌋ UB = \lfloor np + n\epsilon \rfloor U B = ⌊ n p + n ϵ ⌋ Z Z Z
Pr [ L B ≤ Z ≤ U B ] = Pr [ n p − n ϵ ≤ Z ≤ n p + n ϵ ] ≥ 1 − δ / 2
\begin{array}{rl}
\Pr[LB \le Z \le UB] &= \Pr[np - n\epsilon \le Z \le np + n\epsilon] \\
&\ge 1 - \delta/2
\end{array}
Pr [ L B ≤ Z ≤ U B ] = Pr [ n p − n ϵ ≤ Z ≤ n p + n ϵ ] ≥ 1 − δ /2 As p ≤ 0.5 p \le 0.5 p ≤ 0.5
n = ⌈ n / 2 − n ϵ ⌉ + ⌊ n / 2 + n ϵ ⌋ ≥ ⌈ n p − n ϵ ⌉ + ⌊ n p + n ϵ ⌋
n = \lceil n/2 - n\epsilon \rceil + \lfloor n/2 + n\epsilon \rfloor \ge \lceil np - n\epsilon \rceil + \lfloor np + n\epsilon \rfloor
n = ⌈ n /2 − n ϵ ⌉ + ⌊ n /2 + n ϵ ⌋ ≥ ⌈ n p − n ϵ ⌉ + ⌊ n p + n ϵ ⌋ Therefore,
L B ≤ U B ≤ n − L B
LB \le UB \le n - LB \\
L B ≤ U B ≤ n − L B Since ( n k ) \binom{n}{k} ( k n ) k < n / 2 k < n / 2 k < n /2 k > n / 2 k > n / 2 k > n /2
( n L B ) ≤ ( n U B )
\binom{n}{LB} \le \binom{n}{UB}
( L B n ) ≤ ( U B n ) For L B ≤ k ≤ U B LB \le k \le UB L B ≤ k ≤ U B
( n L B ) ≤ ( n k )
\binom{n}{LB} \le \binom{n}{k}
( L B n ) ≤ ( k n ) Define q = L B n q = \frac{ LB }{n} q = n L B
( n L B ) ≥ 1 n + 1 2 n H ( L B n ) ≥ 1 n + 1 2 n H ( p − ϵ )
\binom{n}{LB} \ge \frac{1}{n + 1} 2^{n \mathbf{H}( \frac{ LB }{n} ) } \ge \frac{1}{n + 1} 2^{n\mathbf{H}(p - \epsilon)}
( L B n ) ≥ n + 1 1 2 n H ( n L B ) ≥ n + 1 1 2 n H ( p − ϵ ) By Theorem 1
E [ ∣ s ∣ ] = ∑ k = 1 n E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] ≥ ∑ k = L B U B E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] ≥ ∑ k = L B U B ( ⌊ log 2 ( n k ) ⌋ − 1 ) ( n k ) p k ( 1 − p ) n − k ≥ ∑ k = L B U B ( ⌊ log 2 ( n L B ) ⌋ − 1 ) ( n k ) p k ( 1 − p ) n − k = ( ⌊ log 2 ( n L B ) ⌋ − 1 ) Pr [ L B ≤ Z ≤ U B ] ≥ ( n H ( p − ϵ ) − log 2 ( n + 1 ) ) ( 1 − δ / 2 ) = ( H ( p − ϵ ) H ( p ) − log 2 ( n + 1 ) n H ( p ) ) ( 1 − δ / 2 ) ⋅ n ⋅ H ( p ) = ( H ( p − ln 2 δ 2 n ) H ( p ) − log 2 ( n + 1 ) n H ( p ) ) ( 1 − δ / 2 ) ⋅ n ⋅ H ( p )
\begin{aligned}
\mathbf{E}[|s|] &= \sum_{k = 1}^n \mathbf{E}\left[ |s| \mid Z = k \right] \Pr[Z = k] \\
&\ge \sum_{k = LB}^{UB} \mathbf{E}\left[ |s| \mid Z = k \right] \Pr[Z = k] \\
&\ge \sum_{k = LB }^{UB } \left( \left\lfloor \log_2 \binom{n}{k} \right\rfloor - 1 \right) \binom{n}{k} p^k (1 - p)^{n - k} \\
&\ge \sum_{k = LB }^{UB } \left( \left\lfloor \log_2 \binom{n}{ LB } \right\rfloor - 1 \right) \binom{n}{k} p^k (1 - p)^{n - k} \\
&= \left( \left\lfloor \log_2 \binom{n}{ LB } \right\rfloor - 1 \right) \Pr[LB \le Z \le UB] \\
&\ge \left( n \mathbf{H}(p - \epsilon) - \log_2 (n + 1) \right) (1- \delta / 2) \\
&= \left( \frac{\mathbf{H}(p - \epsilon)}{\mathbf{H}(p) } - \frac{\log_2 (n + 1) }{ n\mathbf{H}(p) }\right) (1- \delta / 2 ) \cdot n \cdot \mathbf{H}(p) \\
&= \left( \frac{\mathbf{H} \left(p - \sqrt{\frac{\ln \frac{2}{\delta} }{2n} } \right) }{\mathbf{H}(p) } - \frac{\log_2 (n + 1) }{ n\mathbf{H}(p) }\right) (1- \delta / 2 ) \cdot n \cdot \mathbf{H}(p) \\
\end{aligned}
E [ ∣ s ∣ ] = k = 1 ∑ n E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] ≥ k = L B ∑ U B E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] ≥ k = L B ∑ U B ( ⌊ log 2 ( k n ) ⌋ − 1 ) ( k n ) p k ( 1 − p ) n − k ≥ k = L B ∑ U B ( ⌊ log 2 ( L B n ) ⌋ − 1 ) ( k n ) p k ( 1 − p ) n − k = ( ⌊ log 2 ( L B n ) ⌋ − 1 ) Pr [ L B ≤ Z ≤ U B ] ≥ ( n H ( p − ϵ ) − log 2 ( n + 1 ) ) ( 1 − δ /2 ) = ( H ( p ) H ( p − ϵ ) − n H ( p ) log 2 ( n + 1 ) ) ( 1 − δ /2 ) ⋅ n ⋅ H ( p ) = H ( p ) H ( p − 2 n l n δ 2 ) − n H ( p ) log 2 ( n + 1 ) ( 1 − δ /2 ) ⋅ n ⋅ H ( p ) ∃ N > 0 \exists N > 0 ∃ N > 0 ∀ n > N \forall n > N ∀ n > N ( H ( p − ln 2 δ 2 n ) H ( p ) − log 2 ( n + 1 ) n H ( p ) ) ≥ ( 1 − δ / 2 ) \left( \frac{\mathbf{H} \left(p - \sqrt{\frac{\ln \frac{2}{\delta} }{2n} } \right) }{\mathbf{H}(p) } - \frac{\log_2 (n + 1) }{ n\mathbf{H}(p) }\right) \ge (1 - \delta / 2) H ( p ) H ( p − 2 n l n δ 2 ) − n H ( p ) l o g 2 ( n + 1 ) ≥ ( 1 − δ /2 )
As for the upper bound, observe that
( n k ) p k ( 1 − p ) n − k ≤ 1
\binom{n}{k} p^k ( 1- p)^{n - k} \le 1
( k n ) p k ( 1 − p ) n − k ≤ 1 Therefore, ( n k ) ≤ p − k ( 1 − p ) − ( n − k ) \binom{n}{k} \le p^{-k} ( 1- p)^{-(n - k) } ( k n ) ≤ p − k ( 1 − p ) − ( n − k )
E [ ∣ s ∣ ] = ∑ k = 1 n E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] ≤ ∑ k = 1 n ( log 2 ( n k ) ) ( n k ) p k ( 1 − p ) n − k ≤ ∑ k = 1 n ( n k ) p k ( 1 − p ) n − k log 2 1 p k ( 1 − p ) n − k
\begin{aligned}
\mathbf{E}[|s|] &= \sum_{k = 1}^n \mathbf{E}\left[ |s| \mid Z = k \right] \Pr[Z = k] \\
&\le \sum_{k = 1}^n \left( \log_2 \binom{n}{k} \right) \binom{n}{k} p^k (1 - p)^{n - k} \\
&\le \sum_{k = 1}^n \binom{n}{k} p^k (1 - p)^{n - k} \log_2 \frac{1}{ p^k (1 - p)^{n - k} }
\end{aligned}
E [ ∣ s ∣ ] = k = 1 ∑ n E [ ∣ s ∣ ∣ Z = k ] Pr [ Z = k ] ≤ k = 1 ∑ n ( log 2 ( k n ) ) ( k n ) p k ( 1 − p ) n − k ≤ k = 1 ∑ n ( k n ) p k ( 1 − p ) n − k log 2 p k ( 1 − p ) n − k 1 The last term is exactly the entropy of the string. By independence of the bits, we know that it is equal to n H ( p ) n \mathbf{H}(p) n H ( p )
Remark: we may also prove it algebraically.
E [ ∣ s ∣ ] ≤ ∑ k = 0 n ( n k ) p k ( 1 − p ) n − k log 2 1 p k ( 1 − p ) n − k = ∑ k = 1 n ( n k ) p k ( 1 − p ) n − k log 2 1 p k + ∑ k = 0 n ( n k ) p k ( 1 − p ) n − k log 2 1 ( 1 − p ) n − k = ( p log 2 1 p ) ∑ k = 1 n ( n k ) k p k − 1 ( 1 − p ) n − k + ( ( 1 − p ) log 2 1 1 − p ) ∑ k = 0 n − 1 ( n k ) ( n − k ) p k ( 1 − p ) n − k − 1 = ( p log 2 1 p ) [ ( x + ( 1 − p ) ) n ] x = p ′ + ( ( 1 − p ) log 2 1 1 − p ) [ ( p + x ) n ] x = 1 − p ′ = n H ( p )
\begin{aligned}
\mathbf{E}[|s|]
&\le \sum_{k = 0}^n \binom{n}{k} p^k (1 - p)^{n - k} \log_2 \frac{1}{ p^k (1 - p)^{n - k} } \\
&= \sum_{k = 1}^n \binom{n}{k} p^k (1 - p)^{n - k} \log_2 \frac{1}{ p^k } + \sum_{k = 0}^n \binom{n}{k} p^k (1 - p)^{n - k} \log_2 \frac{1}{ (1 - p)^{n - k} } \\
&= \left( p \log_2 \frac{1}{p} \right) \sum_{k = 1}^n \binom{n}{k} k p^{k - 1} (1 - p)^{n - k} \\
&\quad + \left( ( 1- p) \log_2 \frac{1}{ 1 - p } \right) \sum_{k = 0}^{n - 1} \binom{n}{k} (n - k) p^k (1 - p)^{n - k - 1} \\
&= \left( p \log_2 \frac{1}{p} \right) [(x + (1 - p))^n]_{x = p}' + \left( (1 - p) \log_2 \frac{1}{ 1 - p } \right) [(p + x)^n]_{x = 1-p}' \\
&= n \mathbf{H}(p)
\end{aligned}
E [ ∣ s ∣ ] ≤ k = 0 ∑ n ( k n ) p k ( 1 − p ) n − k log 2 p k ( 1 − p ) n − k 1 = k = 1 ∑ n ( k n ) p k ( 1 − p ) n − k log 2 p k 1 + k = 0 ∑ n ( k n ) p k ( 1 − p ) n − k log 2 ( 1 − p ) n − k 1 = ( p log 2 p 1 ) k = 1 ∑ n ( k n ) k p k − 1 ( 1 − p ) n − k + ( ( 1 − p ) log 2 1 − p 1 ) k = 0 ∑ n − 1 ( k n ) ( n − k ) p k ( 1 − p ) n − k − 1 = ( p log 2 p 1 ) [( x + ( 1 − p ) ) n ] x = p ′ + ( ( 1 − p ) log 2 1 − p 1 ) [( p + x ) n ] x = 1 − p ′ = n H ( p ) ■ \blacksquare ■
Reference.
[1] S. Har-Peled, “Chapter 26 Entropy, Randomness, and Information,” p. 6.
← Back to all notes Back to top ↑